Tolerância a falhas, intolerância a erros: um equilíbrio essencial na inovação
flexM4I > abordagens e práticas > Tolerância a falhas, intolerância a erros: um equilíbrio essencial na inovação (versão 4.0)
Autoria: Henrique Rozenfeld ([email protected])
Introdução
A inovação é intrinsecamente propensa a falhas e erros, visto que envolve a exploração de territórios incertos e desconhecidos.
Em condições estáveis, metas bem definidas orientam o planejamento, que coordena os esforços para que as organizações possam capturar oportunidades ou mitigar riscos contextuais (Coccia, 2023).
Contudo, em ambientes turbulento, marcados por elevada incerteza,a probabilidade de insucesso em projetos de inovação aumenta, resultando em investimentos desperdiçados, desempenho comercial aquém do esperado e custos acima dos previstos, com impactos diretos no desempenho organizacional.
Diante desse cenário, a questão central não é evitar falhas a qualquer custo, mas definir como as organizações lidam com falhas e erros ao inovar.
Para evitar ambiguidades, esta seção separa dois modos de gestão que precisam coexistir:
- Na exploração de novas oportunidades, tolerância a falhas significa permitir falhas inteligentes de experimentos bem desenhados, com contenção de risco e foco em aprender rápido para decidir os próximos passos.
- Na operação, na escala e na inovação incremental, intolerância a erros significa não normalizar erros evitáveis e reincidentes, porque eles degradam confiabilidade, custo e segurança. Intolerância a erros não é caça às bruxas: é disciplina, transparência e correção rápida para impedir a recorrência.
Existem duas formas de se lidar com falhas, segundo Danneels & Vestal (2020):
- Normalizá-las, tratando-as como parte natural e inevitável da inovação, sem aprofundar a análise. Essa postura reduz o desconforto no curto prazo, mas tende a contribuir pouco para a maturidade de gestão, pois enfraquece a disciplina de aprender com o que não funcionou.
- Analisá-las de forma estruturada, usando métodos de diagnóstico e revisão para extrair aprendizado e transformar as lições em conhecimento aplicável aos próximos objetivos estratégicos e projetos (principalmente de inovação). Essa abordagem fortalece práticas e decisões futuras, reduz recorrências e aumenta a qualidade das escolhas.
Nesse contexto, abordagens como Lean Startup ganharam destaque ao sistematizar ciclos rápidos de aprendizado por meio da experimentação e validação de hipóteses (Ries, 2011; Blank, 2007, 2012). A popularização desses princípios levou muitos autores e profissionais a adotarem a ideia de que falhar rapidamente e com baixo investimento seria condição para a geração de inovações relevantes. No entanto, essa interpretação simplificada frequentemente ignora diferenças importantes de contexto, natureza dos riscos envolvidos e implicações organizacionais mais amplas.
Inovações incrementais e iniciativas de melhoria contínua operam sob o mesmo regime de disciplina da operação: erros evitáveis e reincidentes são inaceitáveis, mesmo quando o objetivo é inovar. Nesse contexto, o aprendizado ocorre por análise e validação prévia. A execução deve ser disciplinada: falhas de aprendizado são aceitáveis antes da implementação, mas erros evitáveis e reincidentes são inaceitáveis durante a operação.
A próxima figura ilustra esses conceitos.
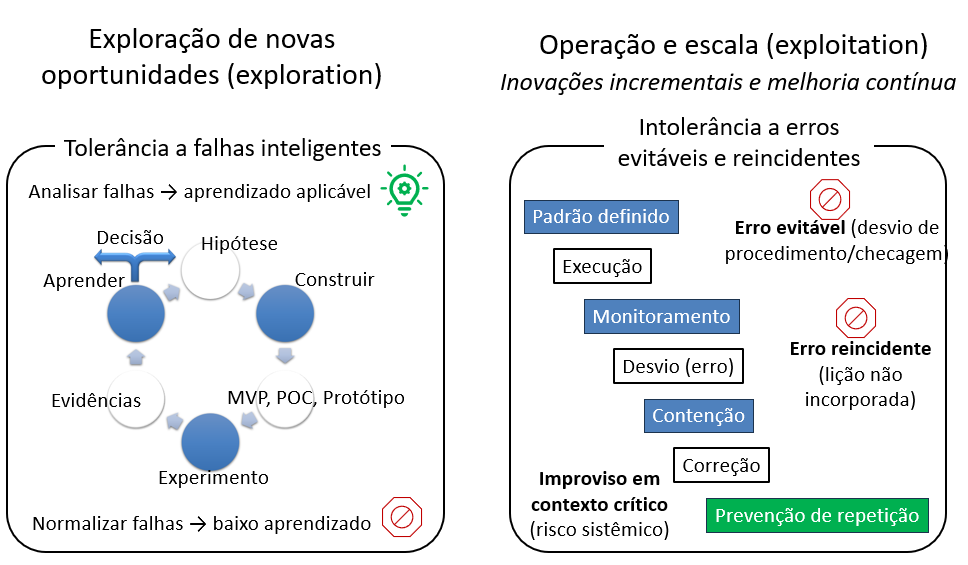
Figura 1428: Tolerância a falhas na exploração e intolerância a erros na operação e na inovação incremental
Existem diversas perspectivas relacionadas com falhas no contexto da inovação.
Alguns estudos mostram que o estabelecimento de metas excessivamente ousadas, associado a falhas recorrentes, pode deteriorar comportamentos gerenciais e organizacionais, transformando-se em uma armadilha em vez de um motor de aprendizado.
Estudos também indicam que organizações conseguem extrair aprendizados valiosos a partir de falhas em novos projetos quando adotam práticas estruturadas de análise e contam com condições culturais adequadas para o aprendizado (Cannon & Edmondson, 2005).
Isso ocorre se elas adotarem um conjunto de técnicas e se a cultura for apropriada para o aprendizado. A abordagem de Lean Startup (Ries, 2011) e as publicações de Steve Blank (2007,2012) trazem o conceito de que falhas devem estar associadas a aprendizados.
Papel da liderança
Aprender a falhar de forma inteligente exige que os líderes adotem uma perspectiva de longo prazo. Muitos gestores adotam uma visão de curto prazo, focada principalmente no controle eficiente das operações do dia a dia e na gestão de custos. Em contraste, fortalecer a capacidade de aprendizagem de uma organização requer uma perspectiva voltada para a construção de sua capacidade de longo prazo de aprender, crescer e se adaptar ao futuro (Cannon & Edmondson, 2005).
Esta seção
Esta seção parte do princípio de que falhas e erros não são equivalentes, nem devem ser tratados da mesma forma. Mais do que defender a “tolerância a falhas” como um slogan, o objetivo é discutir como estruturar uma tolerância inteligente, baseada em regras claras, limites explícitos e mecanismos de aprendizagem que preservem a disciplina operacional, a segurança e a governança, ao mesmo tempo em que viabilizam a experimentação responsável em contextos de inovação.
Ao longo da seção, essas diferentes perspectivas são organizadas em um modelo coerente que diferencia contextos, explicita quando falhas são aceitáveis ou inaceitáveis e apresenta mecanismos práticos para lidar com falhas e erros de forma consistente.
Falhas versus erros
Apresentamos algumas definições do glossário da flexM4i, complementadas por trechos de publicações consagradas sobre esses dois termos.
Falha técnica - de um equipamento / item
Segundo a ABNT (1994), falha (failure) é o término da capacidade de um item desempenhar sua função requerida.
Falhas são ocorrências nos equipamentos que impedem seu funcionamento ou acarretam perdas graves de desempenho ou ainda prejuízos à qualidade do produto final ou de serviço prestado.
Existem 21 tipos de falhas técnicas citadas nesta norma. Consulte a definição de falha no glossário para conhecer esses tipos de falhas.
Falhas inteligentes para aprender
Vários autores, diferenciam falhas na inovação, chamadas de inteligentes por alguns, com o objetivo de aprendizagem. Antes de apresentar as perspectivas dos principais autores, trazemos a seguir uma síntese de definição do que é uma falha inteligente para aprender:
Falha inteligente para aprender é o resultado não atingido de um experimento deliberadamente planejado para testar hipóteses relevantes em contextos de incerteza, conduzido com limites explícitos de risco, custo e impacto, e que gera evidências confiáveis para orientar decisões futuras (perseverar, ajustar ou interromper uma iniciativa). Essa falha:
- não decorre de negligência, descuido ou erro repetido de execução;
- não compromete a segurança, a conformidade ou a continuidade do negócio;
- é intencional no desenho do experimento, mas não desejada como resultado;
- tem valor gerencial apenas se for analisada e convertida em aprendizado acionável.
Na gestão da inovação, essa falha se manifesta como o não atingimento de um objetivo, independentemente de ter havido erro humano ou não. Na gestão da inovação, a falha:
- é um desfecho do experimento ou iniciativa, quando ela não entrega o valor esperado;
- pode ocorrer mesmo que ninguém tenha cometido um erro;
- é parte natural do processo de descoberta, aprendizado e validação.
A falha da gestão da inovação é parte natural do processo de descoberta, aprendizado e validação.
Exemplos típicos:
- um protótipo que não gera tração de mercado.
- uma hipótese que não se confirma.
- um teste que não valida o comportamento do cliente.
- um experimento cujo custo-benefício não se sustenta.
Porém, em todos esses casos, se intencionalmente desenhados, esses experimentos de validação de hipóteses trazem um grande aprendizado na gestão da inovação.
Seguem agora as nuances dos autores principais.
Como diferentes autores tratam falhas voltadas ao aprendizado
Cannon & Edmondson (2005)
Poucas organizações conseguem aprender efetivamente com falhas, apesar do seu potencial como fonte precoce de alerta e prevenção de problemas mais graves. Isso ocorre porque as características dos sistemas técnicos e sociais tornam difícil identificar, analisar e extrair aprendizado das falhas, que acabam sendo ignoradas.
Ainda assim, existem exceções: algumas organizações tornam as falhas visíveis, analisam-nas de forma sistemática ou até estimulam falhas inteligentes por meio de experimentação estruturada.
Aprender com falhas não é impossível, mas contraria normas e intuições gerenciais. Para torná-lo mais comum, é necessário estruturar atividades-chave — identificar falhas, analisá-las e experimentar — apoiadas por uma mudança no modelo mental da liderança.
Mais do que listas de ações, o aprendizado com falhas exige reconfigurar rotinas, incentivos e a forma como a gestão interpreta a falha, deixando de associá-la à culpa e passando a tratá-la como parte do risco, da incerteza e da melhoria contínua.
Edmondson (2011)
Nem toda falha é igual. Existem três categorias de falhas.
1) As falhas evitáveis (preventable failures) ocorrem em contextos conhecidos, estáveis e bem compreendidos. Elas resultam de erros básicos, como:
- descumprimento de procedimentos,
- falta de treinamento,
- negligência,
- comunicação inadequada.
Essas falhas devem ser eliminadas, por meio de disciplina operacional, padronização, treinamento e controle.
2) As falhas relacionadas à complexidade (complexity-related failures). que surgem em sistemas complexos, nos quais múltiplos fatores interagem de forma não linear. Mesmo com pessoas competentes e processos adequados, falhas podem ocorrer porque:
- o sistema é altamente interdependente,
- há variabilidade difícil de prever,
- pequenas variações se combinam de maneira inesperada.
- São comuns em:
- operações complexas,
- grandes projetos,
- ambientes com alta incerteza operacional.
Essas falhas não podem ser totalmente eliminadas, mas podem ser reduzidas e gerenciadas, com redundâncias, monitoramento, aprendizado contínuo e melhoria sistêmica.
3) As falhas inteligentes (intelligent failures) ocorrem em territórios novos, onde não há conhecimento consolidado. São resultado de experimentação deliberada, com hipóteses claras e riscos controlados. As características dessas falhas são:
- acontecem em pequena escala,
- têm custo limitado,
- produzem aprendizado relevante,
- não decorrem de descuidos ou incompetência.
Essas falhas devem ser toleradas e até incentivadas, porque são fundamentais para inovação, aprendizagem organizacional e adaptação estratégica.
Narduzzo & Forrer (2024)
A falha inteligente não é um insucesso operacional, mas um processo deliberado de geração de conhecimento que desafia o sistema de crenças e pressupostos da organização. Diferentemente das falhas não intencionais, a falha inteligente é projetada ex-ante, com hipóteses explícitas e experimentos cuidadosamente desenhados para testá-las com o objetivo de validação.
Enquanto o aprendizado tradicional com falhas tende a reforçar o conhecimento existente (aprendizado de ciclo simples, inovação incremental), a falha inteligente ativa o aprendizado de duplo ciclo, questionando premissas consolidadas e possibilitando inovação de ruptura em tecnologias, mercados, modelos de negócio e organização.
Nesse sentido, a falha inteligente funciona como um mecanismo deliberado para lidar com incerteza e ambiguidade, estimulando raciocínio abdutivo, revisão de modelos mentais e criação de novos caminhos estratégicos. Para isso, o papel do design intencional dos experimentos, da liderança e da cultura organizacional é central.
| Leia mais na flexM4i sobre pensamento abdutivo I e II como padrões de raciocínio do design thinking. Mostramos inicialmente o que são os pensamentos dedutivo e indutivo. Em seguida mostramos que na criação de valor, a abdução é o padrão de raciocínio criativo. |
Erro
Um erro representa a diferença entre um valor ou uma condição observada ou medida e a correspondente condição ou valor verdadeiro especificado ou teórico. Notas:a) um erro pode ser causado por um item em pane; por exemplo, um erro de cálculo feito por um computador em pane. b) o termo “erro” pode também designar um erro humano” (ABNT, 1994).
Um erro humano representa a ação humana que produz um resultado diferente daquele que se pretendia ou que se deveria obter” (ABNT, 1994).
Podemos interpretar o erro humano como um desvio em relação ao comportamento esperado, normalmente associado a uma ação humana inadequada, uma decisão mal tomada, um procedimento seguido de forma incorreta ou uma premissa equivocada.
Nas empresas, o erro:
- é um equívoco no processo, na execução ou no julgamento;
- tende a ter origem humana (mas também pode ser de concepção);
- é frequentemente evitável com treinamento, revisão de processos, protocolos e checklists.
Exemplos típicos:
- interpretar errado um critério.
- deixar de fazer uma verificação obrigatória.
- assumir uma hipótese sem dados suficientes.
- programar um parâmetro incorretamente.
Inovação, por natureza, é incerta e ambígua, exigindo que as organizações aceitem que erros farão parte do processo. Erros podem, inclusive, levar a descobertas acidentais (serendipity) ou ser um subproduto da inovação.
Depois de definir o que são falhas e erros na gestão da inovação, a questão central passa a ser contextual: em que situações falhas podem ser aceitáveis, e em quais contextos elas são inaceitáveis e perigosas.
Quando falhas (e erros) são inaceitáveis
Em atividades centrais do negócio, associadas ao core operacional e à lógica de exploitation (H1), o objetivo da gestão é garantir confiabilidade, segurança, conformidade e eficiência. Nesses contextos, “aprender com a falha” não é uma estratégia aceitável, mas um risco operacional, legal e reputacional, pois o sistema não existe para explorar incertezas, e sim para reduzir variabilidade e evitar desvios.
Aqui, o objetivo é prevenir, detectar cedo e conter rapidamente. Se algo der errado, a resposta esperada é correção imediata e ajuste de controles — não “normalização”.
Contextos de alta confiabilidade, segurança e compliance
Isso ocorre especialmente em contextos de alta confiabilidade, ou seja, quando se necessita de baixa taxas de falhas, nos quais o dano potencial é elevado ou irreversível.
São ambientes onde temos que garantir a segurança de pessoas, integridade de ativos críticos, privacidade e dados, requisitos regulatórios, fraudes e controles financeiros.
A principal regra de negócios neste contexto é ter uma tolerância quase zero a desvios. Devemos para a linha de produção, por exemplo, quando um limite de segurança/compliance é ultrapassado.
Os mecanismos típicos empregados aqui são:
- padrões mandatórios,
- segregação de funções,
- auditoria,
- rastreabilidade,
- validações independentes,
- redundância e
- simulações antes de ir a campo.
Erros evitáveis em processos repetitivos ou conhecidos
O mesmo raciocínio se aplica a processos repetitivos, estáveis e bem conhecidos.
Se o processo é estável e conhecido, o erro é sinal de disciplina fraca, padrão mal definido, treinamento insuficiente ou controle inadequado. Não aceitar a recorrência dos erros. A primeira ocorrência aciona correção, e se houver a repetição do erro, devemos acionar a revisão de causa, padrão e responsabilidade.
Os mecanismos típicos empregados aqui são:
- trabalho padronizado,
- checklists simples,
- revisões por pares,
- automação de checagens,
- “poka-yoke”,
- controle de mudanças e
- qualificação antes de executar.
A recorrência do erro é sempre inaceitável.
Grandes apostas estratégicas e riscos sistêmicos
Há ainda situações em que falhas são inaceitáveis não por estarem associadas à execução rotineira, mas pelo seu potencial de gerar impactos sistêmicos sobre a organização. Em grandes apostas estratégicas, uma única decisão pode comprometer de forma ampla e duradoura o desempenho do negócio, afetando simultaneamente finanças, operações, reputação e a própria viabilidade futura da empresa.
Esse tipo de situação ocorre, por exemplo, quando a decisão “puxa a empresa inteira”: investimentos de grande monta e baixa reversibilidade, migrações de plataformas críticas, mudanças amplas no modelo de negócio, exposição relevante da marca ou dependência excessiva de um único parceiro estratégico.
Nesses casos, a regra de gestão não é aprender após a falha, mas reduzir incerteza antes de escalar decisões, evitando apostas baseadas apenas em crença e exigindo evidência incremental e limites claros de exposição financeira, operacional e reputacional.
Os mecanismos típicos empregados aqui são:
- fases com critérios de passagem claros,
- validações externas/independentes,
- pilotos com raio de impacto limitado,
- planos de contingência,
- gatilhos de reversão e
- pré-mortem e cenários de estresse.
| Pré-mortem e cenários de estresse referem-se a práticas usadas antes da decisão ou execução, para antecipar riscos e reduzir surpresas: – Pré-mortem: exercício em que a equipe assume que a iniciativa fracassou no futuro e identifica, retroativamente, as principais causas desse fracasso, transformando-as em riscos a mitigar. – Cenários de estresse: simulações de situações extremas, porém plausíveis, para testar a robustez da decisão, do modelo ou do plano diante de choques operacionais, financeiros ou de mercado. Leia mais sobre pre-mortem na wikipedia em inglês. |
Quando falhas são aceitáveis (e como lidar com erros)
Em atividades associadas à exploração de novas oportunidades típicas dos horizontes H2 e H3 e da lógica de exploration, a empresa atua deliberadamente em contextos de incerteza, nos quais não há conhecimento consolidado sobre tecnologias, mercados ou modelos de negócio.
Nesses contextos, falhas podem ser aceitáveis e até esperadas, desde que resultem de experimentos intencionalmente desenhados para reduzir incerteza e gerar aprendizado relevante.
Isso não significa relativizar erros. Mesmo em exploration, erros devem ser geridos de forma explícita, com foco em detecção rápida, contenção de impacto, aprendizado e redução de recorrência. O que muda, portanto, não é a definição de falha ou erro, mas a lógica de gestão aplicada a cada contexto.
Domínios complexos, experimentos safe-to-fail e aprendizagem validada
Em domínios complexos, nos quais relações de causa e efeito só se tornam claras retrospectivamente, a inovação não avança por planejamento detalhado e previsibilidade, mas por meio de experimentos deliberados. Nesses contextos, o caminho não pode ser totalmente antecipado; ele se revela à medida que a organização testa hipóteses, observa sinais do ambiente e ajusta progressivamente a direção.
É nesse tipo de situação que se aplicam os experimentos safe-to-fail: testes desenhados para explorar incertezas relevantes com limites explícitos de custo, tempo, risco e impacto. É o caminho proposto por Snowden & Boone (2007): testar, capturar sinais e ajustar a direção (em vez de exigir previsibilidade total).
Quando uma hipótese não se confirma, ou seja, quando o experimento “falha” em validar o que se esperava, esse resultado é aceitável e esperado, desde que gere evidência confiável para decidir se a iniciativa deve ser ajustada, perseverada ou cancelada. Esse é o sentido de aprendizagem validada na gestão da inovação (Ries, 2011).
O que não é aceitável, mesmo em contextos de exploration, é a repetição de erros de execução. Problemas como instrumentação inadequada, coleta de dados frágil, critérios de sucesso mal definidos ou descuido com premissas básicas não representam falhas de hipótese, mas falhas de método.
Mesmo em ciclos como o Build–Measure–Learn, o aprendizado ocorre principalmente pelo ajuste do desenho do experimento (protocolos, métricas, critérios de parada e checagens) e não pela tolerância a erros recorrentes ou pela tentativa de “consertar o sistema inteiro” após resultados ruins.
Portfólios de inovação e taxas esperadas de insucesso
No nível do portfólio, a aceitação de falhas assume uma lógica diferente da gestão de projetos isolados.
Um portfólio saudável assume que algumas iniciativas serão descartadas, ou seja, uma parte relevante das iniciativas não chegará ao mercado ou não terá escala. Essa prática protege a empresa de apostar tudo em uma única tese e investir com muito risco..
O foco gerencial não é evitar falhas, mas maximizar aprendizado por recurso investido.
Ou seja, “matar” cedo (e o mais rapidamente possível) o que não sustenta evidências e reforçar o que mostra tração.
Falhas de meta podem estar ligadas a erros de planejamento, execução/implementação e marketing. Detectar as causas evita “lições genéricas” e traz uma melhora no próximo ciclo (Coccia, 2023).
“Falhar rapidamente” reinterpretado
É nesse contexto que a expressão ‘falhar rapidamente’ costuma ser invocada, muitas vezes de forma equivocada.
Fail fast” virou um slogan popular para reforçar a velocidade de aprendizado, mas quase sempre aparece como uma paráfrase (não como citação literal) das abordagens de experimentação do Lean Startup e abordagens semelhantes.
O ponto não é “errar rápido” no sentido de aceitar descuido, improviso ou falta de disciplina. Isso é erro evitável e deve ser tratado como um problema de gestão.
A postura (mentalidade / cultura) é tolerar o “falhar rápido” quando você está testando hipóteses: desenhar experimentos pequenos, com custo e risco limitados, para descobrir cedo o que NÃO funciona.
Uma forma mais fiel de traduzir a intenção é: FALHAR RÁPIDO, BARATO, COM CONTENÇÃO E APRENDIZADO.
Ou seja, devemos:
- estabelecer uma hipótese explícita,
- que tenha um critério de sucesso/fracasso determinado,
- e um gatilho de parada para cancelar (quando necessário) o experimento e
- um evento / tempo / para registrar e compartilhar o aprendizado.
Se não houver aprendizado reutilizável, não foi “falha inteligente”; foi apenas desperdício.
Espaços protegidos para experimentação e métricas adequadas
A aceitação de falhas em contextos de exploration não depende apenas de postura gerencial, mas da criação de espaços organizacionais protegidos para experimentação. Nesses espaços, a lógica de gestão é distinta do core operacional: enquanto no core a régua é confiabilidade, disciplina e conformidade, nos espaços de inovação a régua é aprendizagem rápida com risco controlado.
A separação explícita de ambientes reduz o risco de contaminação entre exploitation e exploration, evitando tanto que práticas exploratórias comprometam operações críticas quanto que exigências operacionais inibam a experimentação. Nesses espaços, erros devem ser geridos com foco em detecção rápida, contenção de impacto e ajuste de método, e não por meio de caça aos culpados, o que inibe transparência e aprendizado.
Para erros, o foco deve estar na recorrência e no tempo de detecção e correção, reconhecendo que, em territórios novos, erros não são totalmente evitáveis, mas sua repetição é gerenciável. Adote uma lógica de gestão de erros: comunicação aberta sobre erros, compartilhamento de conhecimento, ajuda entre pares, detecção rápida e contenção de dano.
Métricas adequadas reforçam essa lógica, priorizando indicadores de aprendizagem e decisão em vez de métricas clássicas de eficiência operacional, tais como (Fischer et al., 2018):
- tempo de ciclo do experimento,
- qualidade da evidência,
- taxa de decisões (pivotar/perseverar/cancelar),
- exposição a risco; e, para erros, recorrência e tempo de detecção/correção (porque erros não são totalmente evitáveis, especialmente em “território novo”).
Como lidar com falhas e erros nos dois contextos: exploitation e exploration
Independentemente do contexto, falhas e erros fazem parte da dinâmica organizacional; o que muda é a forma como devem ser interpretados e tratados pela gestão. Em ambientes de exploitation e exploration, os mesmos eventos exigem respostas distintas, sob pena de gerar riscos operacionais no core ou bloquear o aprendizado na inovação.
Lidar adequadamente com falhas e erros não significa adotar uma postura permissiva, mas distinguir contextos, explicitar limites e aplicar respostas gerenciais coerentes com a lógica de exploitation ou exploration. É essa diferenciação que permite proteger o core operacional e, ao mesmo tempo, sustentar a aprendizagem necessária à inovação (H2 e H3).
Como lidar com falhas nos dois contextos
A forma de lidar com falhas depende diretamente do contexto de gestão em que elas ocorrem.
Em atividades associadas ao exploitation e ao core operacional (H1), falhas são eventos indesejáveis que sinalizam ruptura do sistema e exigem contenção imediata, análise de causas e reforço de controles para evitar recorrência e impacto sistêmico.
O foco da gestão está em restaurar a confiabilidade, proteger pessoas, ativos e reputação, e reduzir a variabilidade do sistema.
Já em contextos de exploration (H2 e H3), falhas de hipótese são parte esperada do processo de descoberta. Nesses casos, o papel da gestão é garantir que a falha ocorra dentro de limites explícitos de risco, custo e impacto, e que o resultado seja rapidamente convertido em aprendizado acionável para decidir se a iniciativa deve ser ajustada, continuada ou interrompida.
O erro gerencial, nesse contexto, não é a falha em si, mas a incapacidade de aprender com ela ou o escalonamento prematuro sem evidência suficiente.
Como lidar com erros nos dois contextos
Erros, diferentemente das falhas, exigem tratamento disciplinado em qualquer contexto, ainda que a resposta gerencial varie.
Em ambientes de exploitation, erros evitáveis indicam fragilidade de processos, padrões ou competências e devem ser corrigidos de forma imediata, com foco na eliminação da causa raiz e na prevenção da repetição. A recorrência do erro é inaceitável e sinaliza falha de gestão.
Em ambientes de exploration, erros também não são desejáveis, mas tendem a ocorrer como subproduto da incerteza e da experimentação. Nesses casos, a gestão deve priorizar a detecção rápida, a contenção de impactos e o ajuste do desenho do experimento (como instrumentação, métricas, critérios de parada e checagens), evitando que erros de execução contaminem o aprendizado.
Em nenhum dos contextos o erro deve ser celebrado; no máximo, deve ser tratado sem punição cega quando reportado cedo e usado para fortalecer o sistema e a capacidade de decisão
Como estruturar uma tolerância inteligente a falhas e erros
A tolerância inteligente a falhas e erros não é resultado apenas de atitude ou discurso, mas da estruturação deliberada de um sistema de gestão que combine experimentação responsável, aprendizado confiável e disciplina operacional. Não se trata de “liberar o erro”, mas de criar condições para testar hipóteses com risco controlado, capturar aprendizado de forma consistente e evitar a repetição de desvios evitáveis.
Um primeiro princípio é definir claramente o campo de testes, separando o core operacional dos espaços de exploration. Em contextos de exploration, a lógica safe-to-fail só funciona quando a experimentação é tratada como parte de um sistema explícito de decisão, com limites claros e responsabilidade definida, evitando improvisação e a contaminação do core operacional.
| a lógica safe-to-fail foi tratada no tópico anterior “Domínios complexos, experimentos safe-to-fail e aprendizagem validada” |
A estruturação adequada também exige práticas sistemáticas de antecipação e de consolidação do aprendizado.
Antes da execução, exercícios de pré-mortem ajudam a explicitar suposições críticas, identificar por que um experimento pode falhar e transformar incertezas relevantes em hipóteses testáveis, com sinais de alerta definidos antecipadamente.
Após a execução, revisões curtas e objetivas (pós-mortem ou after-action reviews) permitem separar falhas de validação de hipótese (que geram aprendizado) de erros de execução ou medição (que exigem correção).
Para que o aprendizado não “morra na reunião”, é necessário adotar mecanismos simples de registro, bancos de lições aprendidas e rituais periódicos de reuso do conhecimento, transformando lições em decisões, regras ou checklists.
| Leia mais na flexM4i sobre “Lições aprendidas: estruturação e aplicação”. |
Por fim, a tolerância inteligente depende de condições organizacionais de sustentação. Isso inclui:
segurança psicológica com disciplina, ou seja, um ambiente em que problemas são reportados cedo, sem punição cega, mas com intolerância à repetição de erros evitáveis
- uma governança leve e explícita, com proteções, alçadas de decisão, gates de risco e compliance,
- responsáveis definidos pelos experimentos e
- trilhas de escalonamento quando algo sai dos limites estabelecidos.
Incentivos também precisam estar alinhados ao comportamento desejado, reconhecendo transparência, aprendizado validado e cancelamento precoce com evidência, e evitando premiar heroísmo operacional ou metas que estimulem a maquiagem de indicadores.
| O tópico “Criar um sistema de recompensas alinhado à inovação”, dentro da seção “Clima organizacional e estilos de liderança” da flexM4i, mostra que, para estimular a inovação, é preciso combinar recompensas extrínsecas (financeiras, prêmios, visibilidade) com incentivos intrínsecos (autonomia, desafios, aprendizado). Incentivos eficazes devem ser personalizados para diferentes perfis de colaboradores, alinhados aos estágios do processo inovador e embasados no desempenho. Também se recomenda evitar sistemas de recompensa que estimulem rivalidades internas, já que a colaboração é vista como um fator essencial à inovação. |
Estruturar a tolerância a falhas e erros, portanto, não significa reduzir exigência, mas aumentar a maturidade da gestão, tornando explícitas as regras do jogo para proteger o core operacional e, ao mesmo tempo, sustentar a aprendizagem necessária à inovação.
Tolerar, analisar e aprender: do discurso à mudança real
Na prática, lidar bem com falhas e erros exige distinguir claramente três práticas organizacionais diferentes, com tempos, rotinas e responsabilidades próprias.
Tolerar (postura de gestão, no curto prazo): É a resposta imediata ao resultado negativo: proteger o time de punição automática quando houve bom julgamento e o objetivo era aprender, mantendo o foco no que o resultado revela. Em domínios complexos, a liderança precisa aceitar falhas como parte da lógica de “experimentos safe-to-fail” — pequenos testes para entender o sistema, em vez de apostar em previsões.
Analisar (processo, no médio prazo): É transformar a falha em insight acionável. Aqui entra a diferença que evita a distorção do “vamos falhar mesmo”: normalizar/tolerar, por si só, não garante melhoria. A aprendizagem vem de reflexão deliberada e análise estruturada das falhas (Danneels & Vestal, 2020).
Na prática, isso significa ter um ritual padrão (pós-mortem, review de decisão, revisão de hipóteses, análise de causa), com critérios para classificar:
- foi uma falha “inteligente” (experimento com hipótese e risco controlado)?
- foi um erro evitável (execução, checagem, parâmetro, procedimento)?
Aprender (mudança de sistema, no longo prazo): É quando a organização altera algo concreto: decisão, regra, checklist, padrão de execução, critério de gate, treinamento, governança. Sem essa “mudança do sistema”, o que existe é apenas narrativa de aprendizado. Essa transição exige sair do modelo mental “culpa” e entrar no modelo “risco, incerteza e melhoria contínua”.
Distinguir e articular essas três práticas reduz a reincidência de erros, evita a normalização de falhas evitáveis e torna a tolerância a falhas um instrumento real de melhoria e inovação, e não um discurso vazio.
Sem essa “mudança do sistema”, o que existe é apenas narrativa de aprendizado
Apenas tolerar falhas sem análise tende a perpetuar uma sequência de falhas evitáveis. Organizações que realmente se diferenciam são aquelas que transformam falhas em aprendizado, por meio da extração deliberada e franca de lições, usando isso para inovar melhor do que seus concorrentes (Danneels & Vestal, 2020).
Armadilhas, riscos e checklist de diagnóstico
Não introduzir aqui novos conceitos. Ele existe para evitar más interpretações e ajudar a diagnosticar se a tolerância a falhas está sendo aplicada de forma madura. Por isso, ele é apresentado no formato de checklist.
Erros comuns na interpretação de tolerância a falhas
- Confundir falha com erro: tratar desvio evitável (execução ruim) como se fosse “resultado do experimento”.
- Virar álibi: “falhou porque inovação é assim” para encobrir falta de foco, gestão fraca ou decisões sem evidência.
- Romantizar “fail fast”: valorizar velocidade sem qualidade de hipótese, sem instrumentação e sem critério de parada.
- Misturar ambientes: levar a lógica de exploration para o core (H1) e criar risco operacional desnecessário.
- Medir o que é fácil, não o que importa: volume de experimentos e “atividade” no lugar de aprendizagem validada e decisões tomadas.
- Tratar aprendizado como evento, não como sistema: pós-mortem vira reunião; nada vira padrão, checklist, treinamento ou decisão de portfólio.
Riscos de comunicação, distorções culturais e efeitos colaterais
- “Sloganização”: a empresa comunica “toleramos falhas”, mas não define limites, guardrails e consequências para erro repetido.
- Efeito pêndulo: sai de cultura punitiva para cultura “sem dono” (ninguém se sente responsável por qualidade e disciplina).
- Heroísmo e incêndio: times passam a ser premiados por apagar problemas que eles mesmos criaram, e não por prevenir e aprender.
- Ruído com stakeholders: discurso interno mal calibrado pode ser interpretado como relaxamento de qualidade por clientes, auditoria e áreas de risco.
- Feudos de inovação: “espaços protegidos” viram áreas blindadas, sem transparência e sem conexão com o negócio.
- Efeito colateral clássico: aumento de retrabalho, perda de confiança entre áreas (operação vs. inovação) e fadiga de experimentos.
Avaliar o grau de maturidade da organização em lidar com falhas e erros
Use como diagnóstico rápido (SIM/NÃO). Quanto mais “SIM”, mais a tolerância tende a ser inteligente e controlada.
- Existem limites explícitos de risco (custo, cliente, compliance, reversibilidade) para experimentos?
- Há separação prática entre core operacional e espaços de experimentação (com regras diferentes)?
- Todo experimento tem hipótese, métrica de evidência e critério de parada (perseverar/pivotar/cancelar)?
- Existe “stop-the-line” claro para segurança, compliance e incidentes com cliente?
- A organização diferencia falha de hipótese (aprendizado) de erro de execução/medição (correção)?
- O pós-mortem é curto, padrão e gera ações concretas (padrões, checklists, licoes aprendidas, mudanças de processo) para evitar recorrência?
- Há repositório simples de aprendizados e rotina de reuso (não fica “esquecido” em slides)?
- As lideranças protegem a transparência, mas cobram disciplina (segurança psicológica com responsabilidade)?
- Incentivos recompensam decisões com evidência (inclusive cancelar cedo) e não “atividade” ou heroísmo?
- O portfólio assume descarte e reequilibra investimentos com base em evidência, não em política interna?
Leitura prática do resultado:
- 0–3 SIM: tolerância tende a virar ruído ou permissividade. Priorize limites, critérios de parada e pós-mortem padrão.
- 4–7 SIM: em evolução. O ganho rápido vem de melhorar qualidade de evidência e transformar aprendizado em padrão.
- 8–10 SIM: bom nível de maturidade. O desafio passa a ser escala: manter disciplina com volume e velocidade.
Referências
ABNT (1994). NBR 5462 Confiabilidade e Mantenabilidade.
Blank, S. (2007). The four steps to the epiphany: successful strategies for products that win. John Wiley & Sons.
Blank, S., & Dorf, B. (2012). The startup owner’s manual: The step-by-step guide for building a great company. John Wiley & Sons.
Coccia, M. (2023). New Perspectives in Innovation Failure Analysis : A taxonomy of general errors and strategic management for reducing risks. Technology in Society, 75(June), 102384. https://doi.org/10.1016/j.techsoc.2023.102384
Cannon, M. D., & Edmondson, A. C. (2005). Failing to Learn and Learning to Fail ( Intelligently ): How Great Organizations Put Failure to Work to Innovate and Improve. 38, 299–319. https://doi.org/10.1016/j.lrp.2005.04.005
Danneels, E., & Vestal, A. (2020). Normalizing vs . analyzing : Drawing the lessons from failure to enhance firm innovativeness ☆. Journal of Business Venturing, 35(1), 105903. https://doi.org/10.1016/j.jbusvent.2018.10.001
Edmondson, A. C. (2011). Strategies for learning from failure. Harvard business review, 89(4), 48-55.
Edmondson, A. C. (2023). Right kind of wrong: The science of failing well. Simon and Schuster.
Ferreira, J. J. M., Fernandes, C. I., & Ferreira, F. A. F. (2020). Wearing failure as a path to innovation. Journal of Business Research, 120, 195–202.
Fischer, S., Frese, M., Mertins, J. C., & Hardt-gawron, J. V. (2018). The Role of Error Management Culture for Firm and Individual Innovativeness. APPLIED PSYCHOLOGY: AN INTERNATIONAL REVIEW, 00(00), 1–26. https://doi.org/10.1111/apps.12129
Freisinger, E., & McCarthy, I. P. (2024). What fails and when? A process view of innovation failure. Technovation, 133, 102995.
Jong, I. S. De. (2021). When Wrong Is Right : Leaving Room for Error in Innovation Measurement.
Kurtz;, C. F., & Snowden, D. J. (2003). The new dynamics of strategy : Sense-making in a complex and complicated world. IBM SYSTEMS JOURNAL, 42(3).
Narduzzo, A., & Forrer, V. (2024). Technovation Nurturing innovation through intelligent failure : The art of failing on purpose. Technovation, 131(November 2023), 102951. https://doi.org/10.1016/j.technovation.2024.102951
Pisano, G. P. (2019). The Hard Truth Creativity can be messy . Harvard Business Review, February.
Ries, E. (2011). The lean startup: How today’s entrepreneurs use continuous innovation to create radically successful businesses. New York: Crown Business.
Snowden, D. J., & Boone, M. E. (2007). A Leader’s Framework for Decision Making. Harvard Business Review, November, 1–8.
Starbuck, W. H., & Hedberg, B. (2001). How organizations learn from success and failure. In M. Dierkes, A. Berthoin Antal, J. Child, & I. Nonaka (Eds.), Handbook of organizational learning and knowledge (pp. 1-26). Oxford University Press.